
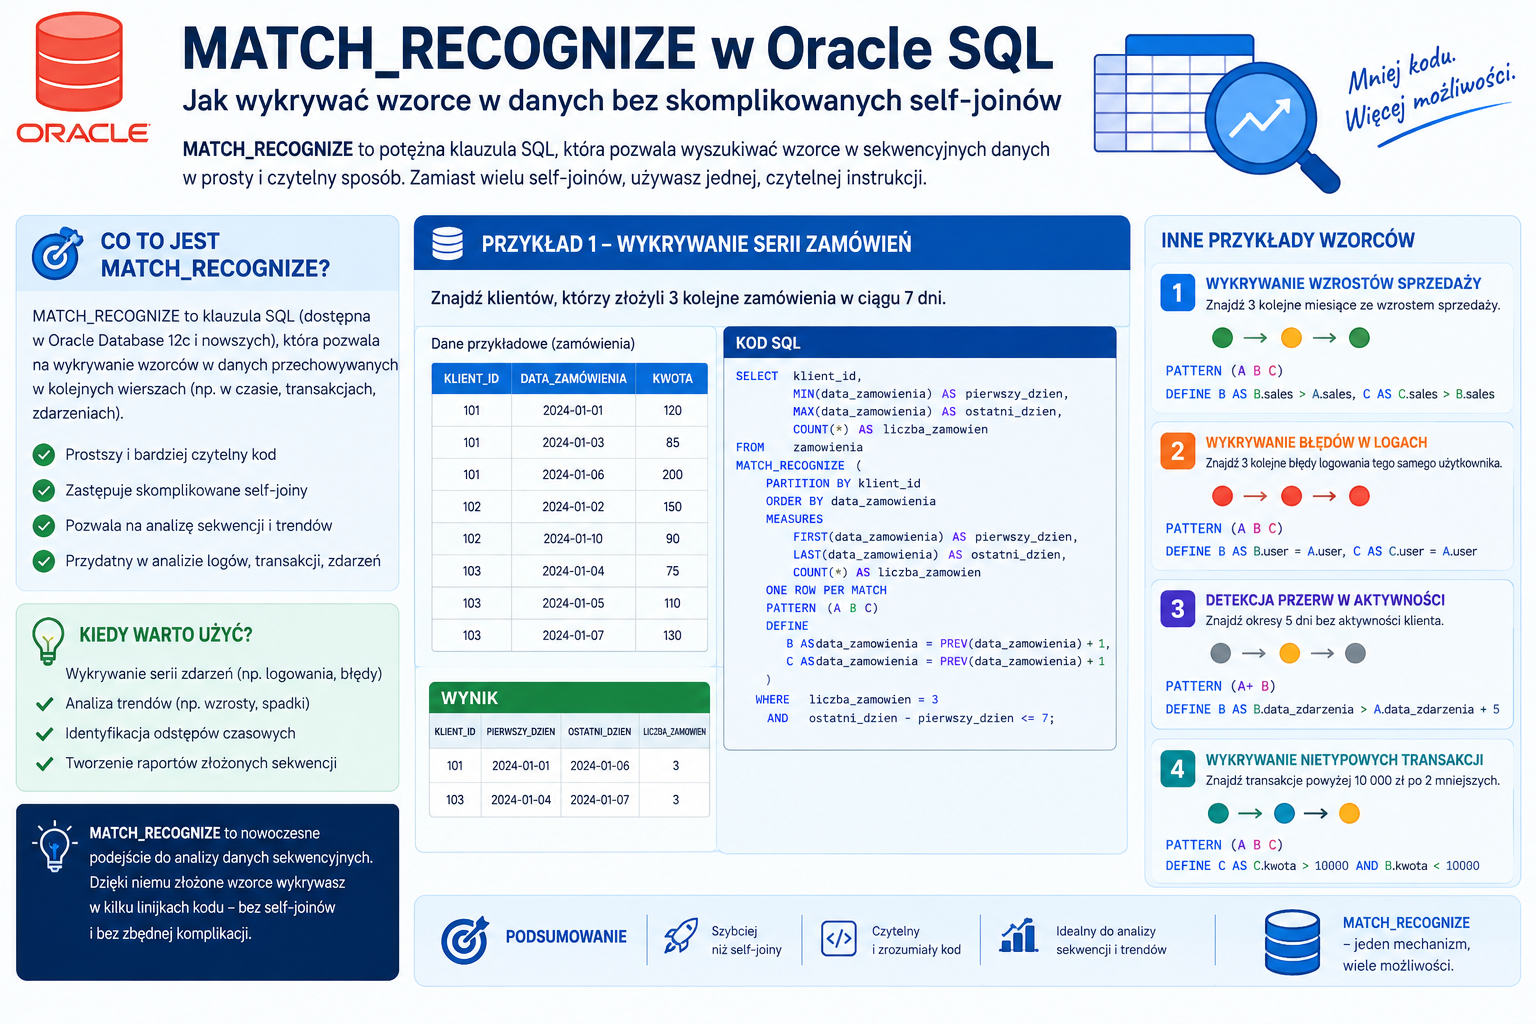
MATCH_RECOGNIZE w Oracle SQL: rozpoznawanie wzorców w danych
Większość osób pracujących na co dzień z Oracle SQL zna GROUP BY, funkcje analityczne typu SUM() OVER() czy klauzulę MODEL. Znacznie mniej osób słyszało o MATCH_RECOGNIZE — a to jedno z najpotężniejszych narzędzi Oracle do szukania wzorców w sekwencjach wierszy, np. „znajdź okres, w którym sprzedaż spadała trzy dni z rzędu, a potem odbiła”.
W tym wpisie pokażemy, do czego MATCH_RECOGNIZE się przydaje i jak napisać pierwszy praktyczny przykład: wykrycie klasycznego wzorca „spadek, dołek, odbicie” w danych sprzedażowych.
Dlaczego warto poznać MATCH_RECOGNIZE?
Klasyczny SQL świetnie radzi sobie z pytaniami typu „ile”, „średnio ile”, „jaka suma”. Gorzej z pytaniami typu: „znajdź sekwencję wierszy, która spełnia taki a taki kształt”. Do tej pory rozwiązywano to zwykle za pomocą:
- funkcji analitycznych (
LAG,LEAD) i żmudnego porównywania sąsiednich wierszy, - samodzielnie pisanych procedur PL/SQL z kursorami,
- albo przenoszenia logiki poza bazę danych (do Pythona, Javy).
MATCH_RECOGNIZE pozwala zdefiniować wzorzec (pattern) deklaratywnie, podobnie jak wyrażenie regularne — ale zamiast dopasowywać znaki w tekście, dopasowuje kolejne wiersze danych do zadanego kształtu.
Podstawowa struktura
SELECT *
FROM   dane
MATCH_RECOGNIZE (
    PARTITION BY produkt
    ORDER BY dzien
    MEASURES
        FIRST(spadek.dzien)  AS poczatek_spadku,
        LAST(spadek.dzien)   AS koniec_spadku,
        MATCH_NUMBER()       AS nr_dopasowania
    ONE ROW PER MATCH
    PATTERN (spadek+ dolek odbicie+)
    DEFINE
        spadek   AS cena < PREV(cena),
        dolek    AS cena < PREV(cena),
        odbicie  AS cena > PREV(cena)
)
ORDER BY produkt, poczatek_spadku;
Kluczowe elementy:
- PARTITION BY – dzieli dane na niezależne grupy, w obrębie których szukamy wzorca (tu: osobno dla każdego produktu).
- ORDER BY – kolejność, w jakiej wiersze są analizowane (zwykle chronologiczna).
- MEASURES – wartości, które chcemy zwrócić z dopasowanego wzorca.
- PATTERN – sam wzorzec, zapisany jak wyrażenie regularne (
+oznacza „jeden lub więcej razy”). - DEFINE – definicje warunków dla każdego elementu wzorca (co to znaczy, że wiersz jest „spadkiem” albo „odbiciem”).
Przykład praktyczny: wykrywanie dołków sprzedażowych
Załóżmy tabelę z dzienną sprzedażą produktu:
CREATE TABLE sprzedaz_dzienna (
    produkt  VARCHAR2(30),
    dzien    DATE,
    cena     NUMBER
);

INSERT INTO sprzedaz_dzienna VALUES ('Kurs SQL', DATE '2026-01-01', 120);
INSERT INTO sprzedaz_dzienna VALUES ('Kurs SQL', DATE '2026-01-02', 110);
INSERT INTO sprzedaz_dzienna VALUES ('Kurs SQL', DATE '2026-01-03', 95);
INSERT INTO sprzedaz_dzienna VALUES ('Kurs SQL', DATE '2026-01-04', 105);
INSERT INTO sprzedaz_dzienna VALUES ('Kurs SQL', DATE '2026-01-05', 130);
Chcemy znaleźć każdy okres, w którym cena najpierw spada (jeden dzień lub więcej), osiąga dołek, a potem zaczyna rosnąć:
SELECT produkt, poczatek_spadku, koniec_spadku, cena_dolka
FROM   sprzedaz_dzienna
MATCH_RECOGNIZE (
    PARTITION BY produkt
    ORDER BY dzien
    MEASURES
        FIRST(spadek.dzien) AS poczatek_spadku,
        LAST(spadek.dzien)  AS koniec_spadku,
        LAST(spadek.cena)   AS cena_dolka
    ONE ROW PER MATCH
    PATTERN (spadek+ odbicie+)
    DEFINE
        spadek  AS cena < PREV(cena),
        odbicie AS cena > PREV(cena)
)
ORDER BY produkt, poczatek_spadku;
To zapytanie samodzielnie „przechodzi” przez wiersze i zwraca gotowy okres spadku — bez ani jednej linijki LAG, LEAD czy pętli PL/SQL. Dokładnie to samo zadanie napisane klasycznym SQL-em wymagałoby zwykle kilkunastu linijek z podzapytaniami i numerowaniem grup.
Przydatne opcje, o których warto wiedzieć
ONE ROW PER MATCHvsALL ROWS PER MATCH– pierwsza opcja zwraca jeden podsumowujący wiersz na każde dopasowanie (jak w przykładzie powyżej), druga zwraca wszystkie wiersze wchodzące w skład dopasowania, co przydaje się przy dokładnej diagnostyce.AFTER MATCH SKIP– kontroluje, od którego miejsca Oracle szuka kolejnego dopasowania. Domyślnie (SKIP PAST LAST ROW) nie pozwala na nakładające się dopasowania;SKIP TO NEXT ROWpozwala je znaleźć.PATTERNz operatorami – tak jak w wyrażeniach regularnych:?(opcjonalnie),*(zero lub więcej),{2,4}(od 2 do 4 razy),|(alternatywa).RUNNINGvsFINAL– wALL ROWS PER MATCHmożna liczyć agregaty „na bieżąco” (RUNNING, widzi tylko wiersze do bieżącego) albo dopiero po zakończeniu dopasowania (FINAL).
Kiedy to ma sens, a kiedy nie
MATCH_RECOGNIZE sprawdza się świetnie do:
- wykrywania trendów i punktów zwrotnych w szeregach czasowych (sprzedaż, kursy giełdowe, odczyty z czujników),
- analizy ścieżek użytkownika (sesje, sekwencje zdarzeń w logach),
- wykrywania anomalii i nietypowych sekwencji (np. w danych transakcyjnych).
Nie warto go używać do prostych porównań „wiersz z wierszem” — tam wystarczą LAG/LEAD. Składnia bywa też trudna do odczytania dla osób, które pierwszy raz się z nią stykają, więc warto zaczynać od prostych wzorców (jak powyżej) i dopiero potem przechodzić do bardziej złożonych.
MATCH_RECOGNIZE a klauzula MODEL
Jeśli czytałeś nasz wcześniejszy wpis o klauzuli MODEL w Oracle SQL, to MATCH_RECOGNIZE jest jej naturalnym „sąsiadem”: MODEL służy do obliczeń na komórkach (jak w arkuszu kalkulacyjnym), a MATCH_RECOGNIZE do wyszukiwania wzorców w sekwencjach wierszy. Obie klauzule to zaawansowane, deklaratywne narzędzia Oracle, które potrafią zastąpić dziesiątki linijek PL/SQL.
Podsumowanie
MATCH_RECOGNIZE to jedna z tych funkcji Oracle, o których rzadko się mówi na poziomie podstawowym, a które potrafią rozwiązać problem nierozwiązywalny w rozsądny sposób klasycznym SQL-em. Jeśli pracujesz z danymi czasowymi, sesjami użytkowników albo szukasz wzorców w sekwencjach zdarzeń — zdecydowanie warto dodać ją do swojego zestawu narzędzi.
Chcesz nauczyć się takich technik krok po kroku, na praktycznych przykładach biznesowych? Sprawdź nasze szkolenie SQL dla analityków — program obejmuje m.in. funkcje okna, CTE i analizę szeregów czasowych.